ทำเว็บ Nuxt หรือ Next.js ให้ AI อ่านได้: llms.txt, robots.txt และหน้า Markdown
แยกกฎ crawler ของ AI เป็นกลุ่ม, llms.txt ที่เป็นสารบัญ, URL แบบ Markdown ของทุกหน้า และ IndexNow ตอน publish พร้อมเหตุผลของแต่ละข้อ
ลองถาม AI assistant เรื่องหน้าใดหน้าหนึ่งในเว็บของเรา จะเกิดได้สามแบบ มันตอบจากสิ่งที่เรียนมาตอนเทรน ตอบจาก search index ที่สร้างไว้ก่อนหน้า หรือไปเปิดหน้าเว็บเราตอนนั้นเลย ทั้งสามแบบมีจุดร่วมกันคือ ณ จุดใดจุดหนึ่งมี crawler มาอ่าน HTML ของเรา ส่วนที่เรากำหนดได้คือมันอ่านอะไรได้บ้าง และอ่านได้ง่ายแค่ไหน
ผมทำเครื่องมือสี่อย่างสำหรับเรื่องนี้ไว้ใน plugin SEO ของ Easy CMS ซึ่งเป็น CMS แบบ embedded สำหรับ Nuxt และ Next.js ที่ผมทำอยู่ (บทความแรกของซีรีส์ เล่าที่มาไว้แล้ว) แต่แนวคิดใช้ได้กับทุกเว็บที่ render ฝั่ง server:
กฎใน
robots.txtสำหรับ crawler ของ AI แบ่งตามสิ่งที่มันทำ/llms.txtไฟล์ Markdown สั้นๆ ที่เป็นสารบัญของเว็บ และ/llms-full.txtที่รวมทั้งเว็บไว้ในไฟล์เดียวURL แบบ Markdown ของแต่ละหน้า เช่น
/posts/hello.mdส่ง IndexNow เมื่อหน้าไหนเปลี่ยนในมุมของผู้เข้าชม
แต่ก่อนทั้งหมดนี้ ต้อง render ฝั่ง server ก่อน crawler ของ AI ส่วนใหญ่ไม่รัน JavaScript หน้าที่โหลดเนื้อหาในเบราว์เซอร์จึงดูว่างเปล่าในสายตาของมัน
robots.txt: crawler ของ AI มีสามแบบ
คำว่า "AI crawler" จริงๆ แล้วครอบคลุมงานสามแบบ:
กลุ่ม | ทำอะไร | ถ้าบล็อก |
|---|---|---|
| เก็บข้อความไปเทรนโมเดล | ข้อความของเราจะไม่อยู่ใน training set รอบต่อๆ ไป |
| ทำ index สำหรับ AI search และคำตอบที่อ้างอิงและลิงก์ไปหน้าเว็บ | หน้าเว็บเราจะไม่ขึ้นเป็นแหล่งอ้างอิงอีก |
| เปิดหน้าเว็บเพราะมีคนสั่ง assistant ให้อ่าน | assistant เปิดหน้าเราตามที่คนขอไม่ได้ ผู้ให้บริการบางรายบอกว่า crawler กลุ่มนี้อาจไม่ทำตาม robots.txt เสมอไป |
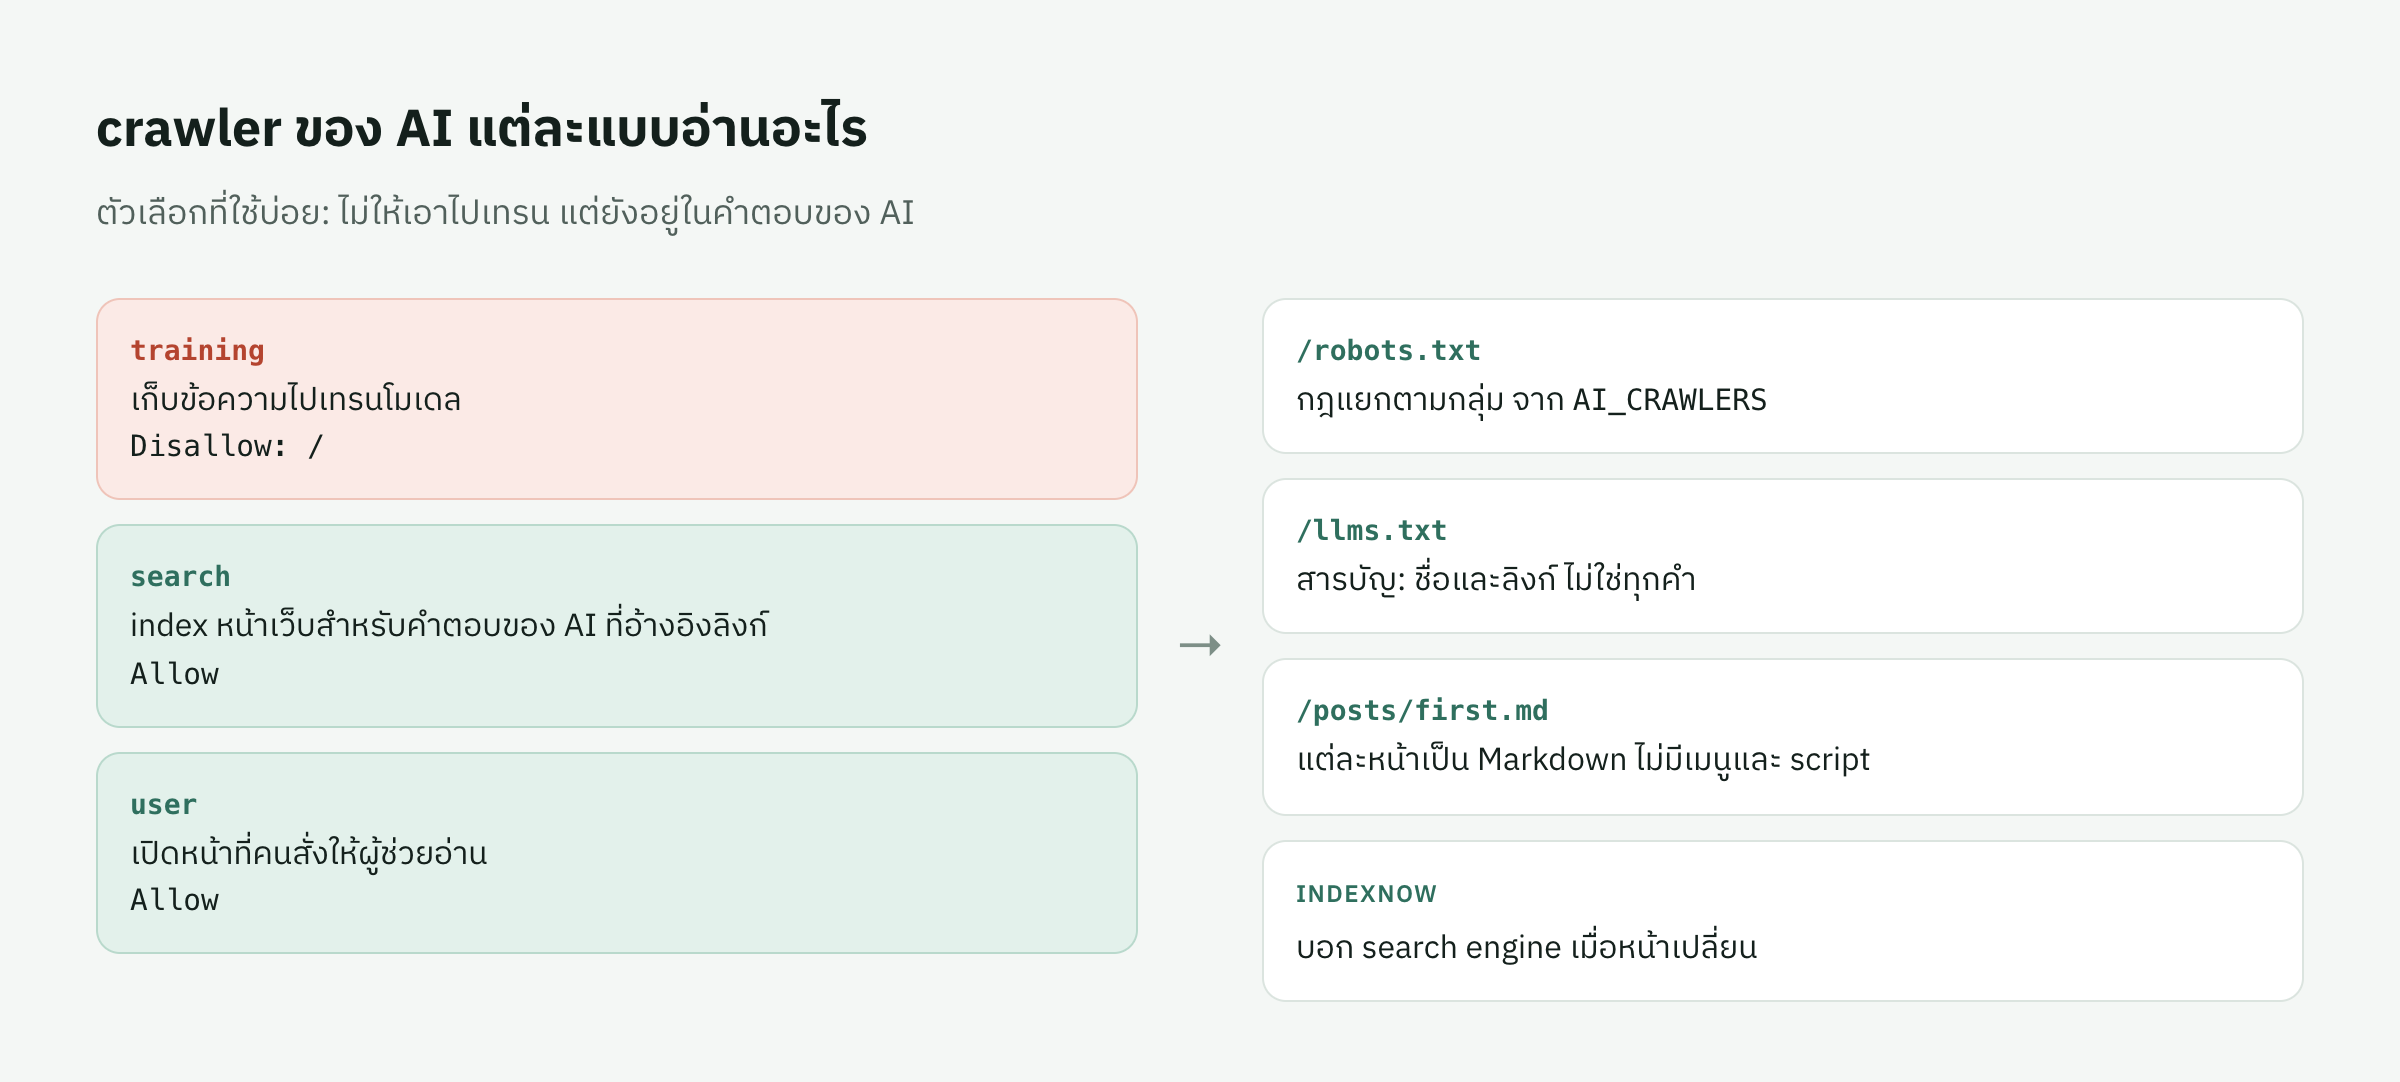
แต่ละบริษัทประกาศชื่อ user-agent ของตัวเอง และชื่อพวกนี้เปลี่ยนได้ อย่า copy รายชื่อจากบล็อกโพสต์มาใช้ Easy CMS เก็บรายชื่อไว้ใน constant ที่ export ไว้ตัวเดียวคือ AI_CRAWLERS แบ่งกลุ่มตามตารางข้างบน และอัปเดตทุก release ดูรายชื่อล่าสุดได้ในคู่มือ SEO สำหรับ AI
ตัวเลือกที่เจอบ่อยคือ ไม่ให้เอาไปเทรน แต่ยังอยากขึ้นในคำตอบของ AI:
// app/robots.txt/route.ts (Next.js)
import { robotsTxt } from '@easy-cms/plugin-seo'
import config from '@/easy-cms.config'

export function GET() {
  // ไม่ให้ crawler ที่เก็บข้อมูลไปเทรนเข้า ส่วน AI search และ assistant ยังอ่านและอ้างอิงบทความได้
  const text = robotsTxt({ config, ai: { training: false } })
  return new Response(text, { headers: { 'content-type': 'text/plain; charset=utf-8' } })
}
ผลลัพธ์ (ตัดให้สั้นลง):
User-agent: *
Allow: /api/cms/media/file/
Disallow: /admin/
Disallow: /api/cms/

User-agent: <หนึ่งบรรทัดต่อ crawler แต่ละตัวในกลุ่ม training>
…
Disallow: /

Sitemap: https://example.com/sitemap.xml
มีสองเรื่องที่ต้องอธิบาย
ค่าเริ่มต้นคืออนุญาตทั้งหมด ถ้าอัปเกรดแล้วกลุ่มไหนถูกบล็อกขึ้นมาเอง เว็บจะหายไปจากคำตอบของ AI โดยไม่มีใครรู้ตัว การบล็อกเป็นการตัดสินใจทางธุรกิจของเจ้าของเว็บ จึงต้องเปิดเอง (opt-in)
ทุกกลุ่มมีกฎพื้นฐานซ้ำอยู่ด้วย crawler จะทำตามเฉพาะกลุ่มที่เจาะจงที่สุดที่ระบุชื่อมัน และไม่เอา User-agent: * มารวมด้วย สมมติเราเพิ่มกลุ่มให้บอทตัวหนึ่งเพื่อ disallow /search บอทตัวนั้นอาจเข้าไป crawl หน้า admin และ API ได้ทันที robotsTxt() จึงใส่กฎของ admin และ API ให้ทุกกลุ่มที่มันเขียน รวมถึงกลุ่มที่เราเพิ่มเองผ่าน rules: [{ userAgent: 'SomeBot', disallow: ['/'] }] ถ้าเขียน robots.txt เอง ให้ copy กฎพื้นฐานไปใส่ในทุกกลุ่ม
llms.txt: สารบัญ ไม่ใช่ที่รวมทุกอย่าง
llms.txt เป็นมาตรฐานที่มีคนเสนอไว้ คือไฟล์ Markdown ที่ root ของเว็บ บอกว่าเว็บนี้คืออะไร และหน้าหลักอยู่ตรงไหน หน้าตาที่ Easy CMS สร้างให้เป็นแบบนี้:
# My Blog

> A blog about building websites in Thailand.

## Posts

- [Hello](https://example.com/posts/hello.md): What this blog is about.

## Pages

- [My Blog](https://example.com/)
ตั้งค่าใน plugin แล้วเสิร์ฟจาก route:
// easy-cms.config.ts (บางส่วน)
seoPlugin({
  collections: ['posts'],
  generateURL: ({ doc }) => `/posts/${doc.slug}`,
  llms: {
    description: 'A blog about building websites in Thailand.',
    limit: 100, // จำนวนหน้าใหม่สุดต่อ collection (ค่าเริ่มต้น)
    markdownURL: ({ doc, collection }) =>
      collection === 'posts' && doc.slug ? `/posts/${doc.slug}.md` : null,
  },
})
// server/routes/llms.txt.ts (Nuxt)
import { llmsTxt } from '@easy-cms/plugin-seo'
export default defineEventHandler(async (event) => {
setHeader(event, 'content-type', 'text/markdown; charset=utf-8')
return llmsTxt(await useEasyCMS())
})ลิงก์ทั้งหมดเป็น absolute URL โดยใช้ { siteURL } ที่เราส่งเข้าไป ถ้าไม่ส่งจะใช้ admin.siteURL ใน config หรือ serverURL ถ้า admin.siteURL ว่าง
เหตุผลเบื้องหลัง:
หน้าชุดเดียวกับ sitemap ทั้งสองไฟล์ใช้ฟังก์ชันเดียวกันที่อ่านเอกสารแบบไม่ login และตัดหน้าที่ติ๊ก "ซ่อนจาก search engine" ออก สองไฟล์นี้จึงไม่มีทางขัดกัน
100 หน้าใหม่สุดต่อ collection llms.txt คือหน้าสารบัญของหนังสือ การ list ทุก URL เป็นหน้าที่ของ sitemap
ภาษาเดียว llms.txt ไม่มีกลไกแบบ
hreflangถ้าใส่ทุกภาษา แต่ละหน้าก็จะซ้ำกันหลายรอบ จึงใช้ default locale หรือllms.localeแยก
markdownURLออกมาgenerateURLยังคงเป็นที่อยู่ของหน้า HTML เพราะ sitemap และ search preview ใช้ค่านี้
เว็บที่มีทั้งไทยและอังกฤษ
ข้อ "ภาษาเดียว" นี้ต้องคิดก่อนเปิดใช้ ถ้าเว็บเรามีเนื้อหาสองภาษา ตัวอย่าง next-blog และ nuxt-blog ใน repo ตั้งไทยเป็นภาษาหลัก:
localization: { locales: ['th', 'en'], defaultLocale: 'th' },เว็บแบบนี้จะได้ llms.txt เป็นภาษาไทยทั้งไฟล์ ทั้งชื่อบทความ คำอธิบาย และหัวข้อของแต่ละ section ซึ่งมาจาก label ของ collection ในภาษานั้น (ในตัวอย่างจะได้ ## บทความ แทน ## Posts) ถ้าอยากให้เครื่องมือ AI เห็นฉบับภาษาอังกฤษแทน ให้ตั้ง llms: { locale: 'en' } ค่านี้มีผลกับ /llms-full.txt ด้วย สรุปคือเว็บที่ไทยเป็นภาษาหลักต้องเลือกเองว่าจะให้ AI เห็นภาษาไหน
/llms-full.txt (llmsFullTxt(cms)) มีไว้สำหรับเครื่องมือที่อยากได้ทั้งเว็บใน request เดียว คือ Markdown ของทุกหน้า เรียงจากใหม่ไปเก่า ไฟล์จะหยุดที่ประมาณ 5 MB (maxBytes) แล้วปิดท้ายด้วยบรรทัดที่ชี้ไปที่ /llms.txt และ /sitemap.xml สำหรับหน้าที่เหลือ
URL แบบ Markdown ของแต่ละหน้า
HTML ห่อข้อความไว้ด้วย navigation, footer และ script ส่วน Markdown มีแค่ตัวข้อความ docMarkdown() เขียนเอกสารหนึ่งชิ้นออกมาเป็น Markdown คือชื่อเรื่อง คำอธิบาย URL วันที่เผยแพร่และวันที่แก้ไข แล้วตามด้วยเนื้อหา
เนื้อหาคือ field แบบ rich text และ textarea ที่อยู่ชั้นบนสุด รวมกับข้อความทุกอย่างที่อยู่ใน blocks และ arrays ส่วน field text ชั้นบนสุดจะถูกข้าม เพราะมักเป็น slug หรือชื่อ ไม่ใช่เนื้อหา ถ้าการเดานี้ผิดสำหรับ collection ไหน ให้ส่งฟังก์ชันของเราเองผ่าน option markdown ของ plugin
ใน Next.js dynamic segment มี .md ต่อท้ายไม่ได้ จึงต้องใช้ rewrite map URL ไปที่ route:
// next.config.ts
rewrites: async () => [{ source: '/posts/:slug.md', destination: '/md/posts/:slug' }],
// app/md/posts/[slug]/route.ts
import { getEasyCMS } from '@easy-cms/next'
import { docMarkdown } from '@easy-cms/plugin-seo'
import config from '@/easy-cms.config'
export const dynamic = 'force-dynamic'
export async function GET(_request: Request, { params }: { params: Promise<{ slug: string }> }) {
const { slug } = await params
const cms = await getEasyCMS(config)
// อ่านในฐานะผู้เข้าชม: ได้เฉพาะบทความที่เผยแพร่แล้ว
const { docs } = await cms.find('posts', {
where: { slug: { equals: decodeURIComponent(slug) } },
limit: 1,
overrideAccess: false,
user: null,
})
const post = docs[0]
if (!post || post.meta.noindex) return new Response('Not found', { status: 404 })
// ที่อยู่ของหน้าเอาจาก config (admin.siteURL) ไม่ใช่จาก Host ของ request
const url = `${cms.config.admin.siteURL.replace(/\/+$/, '')}/posts/${post.slug}`
return new Response(docMarkdown(cms, { collection: 'posts', doc: post, url }), {
headers: { 'content-type': 'text/markdown; charset=utf-8' },
})
}ใน Nuxt ใช้ server middleware ที่ match /^\/posts\/([^/]+)\.md$/ แล้วทำแบบเดียวกัน มีรายละเอียดสามข้อที่สำคัญ ข้อแรก อ่านด้วย overrideAccess: false, user: null เพื่อให้ได้เฉพาะสิ่งที่ผู้เข้าชมเห็นได้ ข้อสอง เคารพ noindex หน้าที่เราซ่อนจากการค้นหาไม่ควรโผล่กลับมาในรูป Markdown ข้อสาม เอาที่อยู่จาก config ไม่ใช่จาก request เพราะ client ส่ง header Host อะไรมาก็ได้ และถ้า response ถูก cache ที่อยู่นั้นจะถูกส่งต่อไปให้ผู้อ่านทุกคน
slug ภาษาไทย ใช้ได้ แต่ต้องรู้ว่ามันมาถึง route แบบ percent-encoded เช่น /posts/ข่าว.md ที่ส่งมาจริงคือ /posts/%E0%B8%82….md เพราะเบราว์เซอร์และ crawler encode ตัวอักษรที่ไม่ใช่ ASCII ใน path ก่อนส่ง ทั้ง route ของ Next.js และ middleware ของ Nuxt จึงเรียก decodeURIComponent ก่อน query ไม่อย่างนั้นจะหาบทความไม่เจอ ส่วนใน llms.txt ลิงก์ยังเป็นตัวอักษรไทยตามเดิม plugin encode ให้แค่ช่องว่างกับวงเล็บ ซึ่งจะทำให้ลิงก์ในรูปแบบ Markdown ขาด
ทำไมไม่ใช้ Accept: text/markdown กับ URL ปกติ URL เดียวที่ตอบได้สองแบบดูสะอาดกว่าก็จริง แต่ cache หลายตัวใช้แค่ URL เป็น key ถ้าทุกชั้นระหว่างเรากับผู้อ่านไม่ได้เคารพ Vary: Accept ทั้งหมด response แบบ Markdown ตัวแรกจะถูก cache ไว้แล้วส่งให้เบราว์เซอร์คนถัดไป หรือกลับกัน URL .md ที่แยกออกมาไม่มีทางสลับกัน
IndexNow: บอก search engine ทันทีที่หน้าเปลี่ยน
crawler กลับมาตามรอบของมันเอง IndexNow ให้เราบอก Bing, Yandex และ search engine อื่นที่เข้าร่วม ว่า URL ไหนเปลี่ยนได้ทันที index ของ Bing ยังป้อนให้ ChatGPT search และ Copilot ด้วย นี่คือเหตุผลที่ผมใส่ไว้ใน plugin นี้
seoPlugin({
  // …
  indexNow: { key: process.env.INDEXNOW_KEY }, // ตัวอักษร ตัวเลข หรือขีด 8–128 ตัว เช่น UUID
})
พฤติกรรมแต่ละส่วนมีเหตุผลของมัน:
เฉพาะการเปลี่ยนแปลงที่ผู้เข้าชมเห็น คือ publish, แก้ไขตอนที่ publish อยู่, unpublish และลบ การบันทึก draft ทับบทความที่ publish แล้วจะไม่ส่ง ping เพราะหน้าจริงยังไม่เปลี่ยน ส่วนนี้ยากกว่าที่คิด ตอนที่มี draft ค้างอยู่
previousDocที่ hookafterChangeได้รับคือ draft นั้น plugin จึงอ่านสถานะที่ publish อยู่ไว้ในbeforeChangeแล้วเทียบหลังบันทึก แลกกับการอ่านเพิ่มหนึ่งครั้งต่อการแก้ไข และเฉพาะตอนเปิด IndexNow เท่านั้น ถ้าเว็บมีหลายภาษา plugin ส่งที่อยู่ของหน้านั้นครบทุกภาษารวมเป็นชุด การเปลี่ยนแปลงจะถูกเก็บไว้ 5 วินาที (
delay) แล้วส่งเป็นหนึ่ง request ต่อ host สูงสุด 10,000 URL ต่อ request publish 40 บทความพร้อมกันก็ส่งแค่ request เดียว ไม่ใช่ 40ไม่ retry ส่งไม่สำเร็จจะ log ไว้แล้วทิ้ง search engine ยัง crawl ตามปกติอยู่แล้ว ping ที่หายไปจึงเสียไม่มาก
เฉพาะ URL
httpsสาธารณะlocalhost, IP address, hostname ที่ไม่มีจุด และโดเมน.test,.local,.example,.invalid,.internalจะถูกข้าม dev server และตอนรันเทสจึงเงียบเองโดยไม่ต้องตั้งค่าอะไร แต่ staging ที่อยู่บนโดเมนสาธารณะจริงจะส่ง ดังนั้นอย่าตั้งINDEXNOW_KEYบน staging
IndexNow ตรวจความเป็นเจ้าของเว็บด้วยไฟล์ key ที่ /<key>.txt และรับเฉพาะ URL ที่อยู่ใต้ตำแหน่งของไฟล์นั้น ไฟล์จึงต้องอยู่ที่ root ตัวอย่างใน repo ตอบไฟล์นี้ด้วย indexNowKeyFile(cms, pathname) ใน Next.js เป็น catch-all app/[file]/route.ts ใน Nuxt เป็น middleware หรือจะวางไฟล์ธรรมดาไว้ใน public/ ก็ได้
trade-off ที่ผมยอมรับไว้: คิว 5 วินาทีนั้นอยู่ใน memory ถ้า deploy บน serverless แล้ว function หยุดก่อนส่ง URL ที่ค้างอยู่จะหายไป บน serverless ให้ตั้ง delay สั้นลง
ทำเองโดยไม่ใช้ Easy CMS
ส่วน | ต้องทำอะไร | กับดัก |
|---|---|---|
robots.txt | หนึ่งกลุ่มต่อประเภทของ crawler ชื่อเอาจากเอกสารของผู้ให้บริการแต่ละราย | กลุ่มที่ระบุชื่อจะไม่สนใจ |
llms.txt | ชื่อเว็บ สรุปหนึ่งบรรทัด หน้าใหม่สุดของแต่ละ section ภาษาเดียว | ใส่ทุก URL และทุกภาษา |
หน้า Markdown | URL | ใช้ content negotiation หลัง cache, หลุด draft หรือหน้า noindex ออกไป, ลืม decode slug ภาษาไทย |
IndexNow | ping เมื่อผู้เข้าชมเห็นการเปลี่ยนแปลง รวมเป็นชุด เฉพาะ https สาธารณะ | ping ทุกครั้งที่บันทึก draft หรือ ping จาก staging |
สิ่งที่ผมยังไม่รู้
llms.txt ยังเป็นข้อเสนอ ไม่ใช่มาตรฐานที่ assistant ทุกตัวอ่าน ผมบอกไม่ได้ว่าตอนนี้มีตัวไหนใช้บ้าง หรือมันเปลี่ยนอันดับของเว็บหรือเปล่า ที่บอกได้คือแต่ละไฟล์ใช้แค่หนึ่ง route และไม่มีไฟล์ไหนเปิดเผยอะไรที่ผู้เข้าชมอ่านไม่ได้อยู่แล้ว
[TODO: เรื่องของคุณ — หนึ่งบรรทัดว่าเห็นอะไรหลังเปิดใช้กับเว็บจริง (เช่น crawler ตัวไหนมาเปิด /llms.txt หรือหน้า .md) หรือลบบรรทัดนี้]
ถ้าอยากได้ตัวอ้างอิง คู่มือ SEO สำหรับ AI มีทุก route ทั้งเวอร์ชัน Nuxt และ Next.js และ examples/next-blog กับ examples/nuxt-blog ใน repository รันครบทุกตัว
Easy CMS เป็น open source (MIT): github.com/maritonx/easy-cms · เอกสารภาษาไทย ถ้าลองแล้วติดตรงไหน บอกผมได้ที่ issue สำหรับ feedback